Reconocimiento de voz
La tecnología que convierte lo que decís en voz alta en texto escrito.
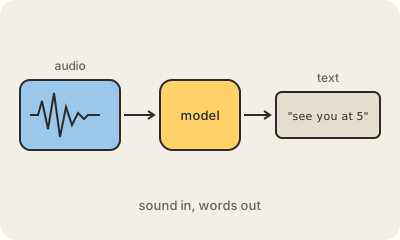
El reconocimiento de voz, también llamado speech-to-text o voz a texto, es lo que le permite a una computadora escuchar a alguien hablar y escribir lo que dijo. El dictado del celular, los subtítulos automáticos de los videos, los asistentes de voz y la transcripción de una videollamada arrancan todos acá.
Los sistemas viejos se armaban con piezas separadas: una para reconocer sonidos, otra para asociarlos a palabras y otra para adivinar las frases más probables. Los modernos son una sola red neuronal entrenada con cientos de miles de horas de audio grabado junto con su transcripción. Whisper, de OpenAI, publicado como open source en 2022, mostró hasta dónde llega ese enfoque: un único modelo que maneja decenas de idiomas y audio con ruido bastante bien.
Igual se sigue equivocando, sobre todo con acentos marcados, ruido de fondo, gente que se pisa al hablar o nombres y jerga que nunca escuchó. Los buenos servicios suman extras como distinguir quién habla, poner puntuación y aceptar una lista de palabras propias. En AWS, el servicio para esto es Amazon Transcribe.
Para quedarse
- Convierte el audio de gente hablando en texto.
- Está detrás del dictado, los subtítulos, los asistentes de voz y las transcripciones.
- Los sistemas actuales son redes neuronales entrenadas con muchísimo audio.
- Los acentos, el ruido y los nombres raros siguen siendo lo difícil.