Cuantización
Guardar los números de un modelo con menos bits para que ocupe menos y ande más rápido.
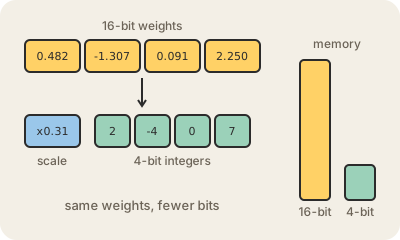
Un modelo entrenado son miles de millones de números, sus pesos, guardados en general como punto flotante de 16 bits (FP16 o BF16): dos bytes cada uno. La cuantización los pasa a un formato más chico, típicamente enteros de 8 o de 4 bits. Un modelo de 70.000 millones de parámetros baja de unos 140 GB de pesos a unos 35 GB en 4 bits: la diferencia entre necesitar varias GPUs de data center y entrar en una sola grande.
El truco central es un factor de escala. Los pesos se parten en bloques chicos, de 32 o 128 valores por ejemplo; cada bloque guarda una escala con más precisión, y cada peso pasa a ser un entero chico que, multiplicado por esa escala, se aproxima al original. Redondear tira información, así que métodos como GPTQ y AWQ eligen el redondeo con cuidado usando unos pocos datos de muestra y protegen los pesos que más pesan en el resultado. Formatos como GGUF, el que usan llama.cpp y Ollama, empaquetan estos esquemas para correr modelos en tu propia máquina.
La mayoría de la cuantización se hace después del entrenamiento (post-training quantization) y lleva de minutos a horas. El quantization-aware training simula la baja precisión durante el entrenamiento para que el modelo aprenda a convivir con ella, a un costo mayor. Además de los pesos, se pueden cuantizar las activaciones y la caché KV, y las GPUs recientes traen soporte en hardware para cuentas en punto flotante de 8 y hasta de 4 bits.
La velocidad sale sobre todo de la memoria, no de las cuentas: generar cada token implica leer todos los pesos, así que mover la mitad o la cuarta parte de los bytes acelera la generación antes de cambiar una sola operación. El precio es la calidad. Con 8 bits la pérdida suele ser casi nula; 4 bits es un punto medio muy usado, con una caída chica pero medible; por debajo de eso la calidad se desploma rápido, y los modelos chicos tienden a sufrirlo más que los grandes. Evaluá un modelo cuantizado en tu propia tarea, no solo en un benchmark público.
Para quedarse
- Pasar de 16 a 4 bits divide la memoria de los pesos más o menos por cuatro.
- Los factores de escala por bloque mantienen chico el error de redondeo.
- La generación más rápida viene sobre todo de leer menos bytes por token.
- Con 8 bits casi no se pierde nada; por debajo de 4, la calidad cae rápido.
Para seguir leyendo
- Quantization overview, documentación de Hugging Face Transformers (en inglés)
- Quantization concept guide, Hugging Face Optimum (en inglés)