Descenso de gradiente
El método que ajusta los pesos de un modelo dando pasitos cuesta abajo en su error.
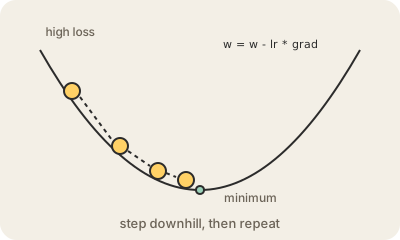
Entrenar una red neuronal es encontrar pesos que hagan chicos sus errores. Esos errores se resumen en una función de pérdida: un solo número que dice qué tan mal le va al modelo con un lote de ejemplos. El descenso de gradiente es la forma estándar de bajarlo. El gradiente es la lista de derivadas parciales de la pérdida respecto de cada peso, y apunta hacia donde la pérdida crece más rápido. Entonces das un paso para el otro lado: w = w - lr * grad, para cada peso, y repetís, muchas veces millones de veces.
La tasa de aprendizaje (learning rate, lr) fija el largo del paso y es la perilla más delicada. Si es muy grande, la pérdida rebota o se dispara; si es muy chica, el entrenamiento avanza a paso de tortuga. Es común arrancar con un calentamiento y bajarla a medida que avanza el entrenamiento. Calcular el gradiente exacto sobre todo el dataset en cada paso sería lentísimo, así que el descenso de gradiente estocástico (SGD) lo estima con un mini-lote chico elegido al azar. La estimación tiene ruido, pero es barata, y ese ruido hasta ayuda a no quedarse trabado en zonas malas.
Los modelos grandes casi nunca usan SGD a secas. Optimizadores como Adam y AdamW llevan promedios de los gradientes anteriores (momentum) y ajustan el paso de cada peso según qué tan grandes vinieron siendo sus gradientes, lo que vuelve el entrenamiento mucho menos caprichoso. Esa contabilidad cuesta memoria: AdamW guarda dos números extra por cada peso, una de las razones por las que entrenar necesita varias veces la memoria que hace falta para solo usar el modelo.
El paisaje de pérdida de una red grande no es un bol prolijo. Tiene una cantidad enorme de dimensiones, mesetas planas y puntos de silla, y el descenso de gradiente no garantiza encontrar el punto más bajo. En la práctica encuentra, de forma confiable, pesos que andan bien con datos nuevos, y por eso entrena prácticamente todos los modelos actuales. Los gradientes salen de la retropropagación; el descenso de gradiente decide qué hacer con ellos. La idea es vieja: el matemático Augustin-Louis Cauchy la describió en 1847.
Para quedarse
- Regla de actualización: cada peso menos la tasa de aprendizaje por su gradiente.
- El SGD estima el gradiente con mini-lotes chicos elegidos al azar.
- Adam y AdamW suman momentum y pasos por peso, a costa de memoria.
- No garantiza el mejor mínimo, pero en la práctica funciona bien.
Para seguir leyendo
- Descenso del gradiente en Wikipedia
- Descenso de gradientes (Curso intensivo de aprendizaje automático de Google)