Destilación de modelos
Entrenar un modelo chico y barato para que imite a uno grande y caro.
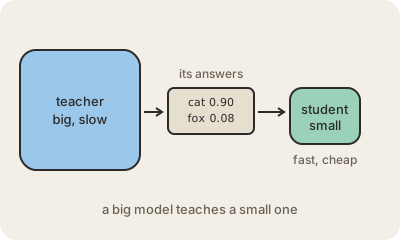
La destilación de modelos, o destilación de conocimiento, es una forma de meter buena parte de lo que sabe un modelo grande dentro de uno más chico. Tomás un modelo maestro grande y capaz, lo hacés correr sobre muchísimas entradas y entrenás un modelo alumno chico para que reproduzca las salidas del maestro, en vez de aprender solo de los datos etiquetados originales.
El truco, descripto en un paper de 2015 de Geoffrey Hinton, Oriol Vinyals y Jeff Dean, es que las probabilidades completas del maestro traen más información que una sola respuesta correcta. Un clasificador de fotos que dice "gato 90 %, zorro 8 %, auto 0,01 %" también le está contando al alumno qué errores son razonables. Con los LLMs actuales la misma idea suele tomar una forma más simple: el maestro genera muchísimas respuestas, o razonamientos paso a paso completos, y ese texto se vuelve datos de entrenamiento para el alumno. A principios de 2025, por ejemplo, DeepSeek publicó varios modelos abiertos chicos destilados de su modelo de razonamiento R1.
La ganancia aparece en la inferencia. Un modelo destilado tiene muchos menos parámetros, así que responde más rápido, cuesta menos por pedido y puede correr en una notebook o un celular. Los límites: el alumno rara vez supera al maestro, pierde más cuanto más se alejan las tareas de aquello con lo que lo destilaron, y muchos proveedores comerciales prohíben en sus términos usar las salidas de sus modelos para entrenar modelos competidores.
Para quedarse
- Un modelo alumno chico aprende a imitar a un modelo maestro grande.
- Las probabilidades o el texto que genera el maestro se vuelven datos de entrenamiento.
- Resultado: inferencia más rápida y barata, que entra en dispositivos chicos.
- El alumno rara vez supera al maestro, y algunos proveedores prohíben destilar sus salidas.
Para seguir leyendo
- Destilación de conocimiento en Wikipedia
- Distilling the Knowledge in a Neural Network (Hinton y otros, 2015, en inglés)