Modelo de razonamiento
Un modelo de IA que resuelve el problema paso a paso antes de contestar.
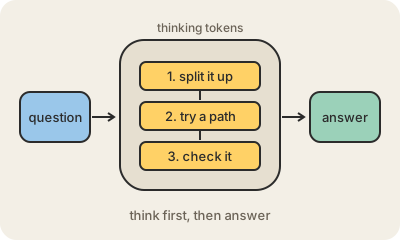
Un modelo de razonamiento es un LLM entrenado para pensar en voz alta antes de responder. En vez de largar la respuesta de una, primero escribe una cadena larga de pasos intermedios: desarma el problema, prueba un camino, revisa el resultado y vuelve atrás cuando algo no cierra. Recién ahí escribe la respuesta final.
La idea despegó a fines de 2024 con o1 de OpenAI, y después vinieron DeepSeek-R1, Claude con razonamiento extendido (extended thinking) y otros. Estos modelos suelen entrenarse con aprendizaje por refuerzo sobre problemas cuya respuesta se puede verificar, como cuentas de matemática o código que tiene que pasar tests, así el modelo aprende qué formas de pensar llevan de verdad a un resultado correcto.
La mejora es real en tareas de varios pasos: matemática, programación, planificación, acertijos, el análisis cuidadoso de un documento largo. El costo también es real: todo ese pensamiento está hecho de tokens, así que las respuestas tardan más y salen más caras. Muchas APIs te dejan fijar un presupuesto de pensamiento, y para una pregunta rápida o reescribir un párrafo, un modelo común suele andar mejor.
Para quedarse
- Escribe un razonamiento intermedio antes de la respuesta final.
- Suele entrenarse con aprendizaje por refuerzo en problemas verificables.
- Rinde más en matemática, código y tareas largas; es más lento y caro.
- Los tokens de pensamiento se cobran, por eso muchas APIs dejan ponerles tope.
Para seguir leyendo
- Modelo de razonamiento en Wikipedia
- Pensamiento extendido (documentación de Anthropic)
- Reasoning models (documentación de OpenAI, en inglés)