Retropropagación
El algoritmo que calcula cuánto contribuyó cada peso al error de una red neuronal.
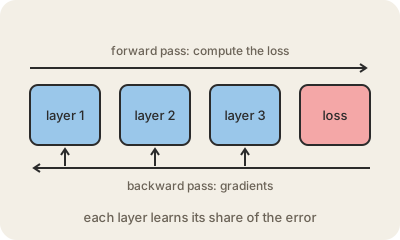
Para mejorar una red neuronal con descenso de gradiente necesitás un gradiente para cada uno de sus pesos: cuánto cambiaría la pérdida si ese peso se moviera un poquito. Con millones o miles de millones de pesos, probarlos de a uno es imposible. La retropropagación (backpropagation) los calcula todos de una sola pasada. Es la regla de la cadena del cálculo, aplicada de forma sistemática desde la salida hacia la entrada.
Funciona en dos pasadas. La pasada hacia adelante (forward pass) hace pasar un lote de ejemplos por la red, capa por capa, calcula la pérdida y guarda en memoria los resultados intermedios (las activaciones). La pasada hacia atrás (backward pass) arranca en la pérdida y recorre las capas al revés. Cada capa recibe el gradiente respecto de su salida, usa sus activaciones guardadas para calcular los gradientes de sus propios pesos y le pasa a la capa anterior el gradiente respecto de su entrada. La pasada hacia atrás cuesta más o menos el doble que la de ida, sin importar cuántos pesos haya.
Hoy nadie la programa a mano. Frameworks como PyTorch y JAX registran las operaciones de la pasada hacia adelante y las derivan solos (diferenciación automática); llamar a loss.backward() en PyTorch es hacer retropropagación. Esas activaciones guardadas son una gran razón por la que el entrenamiento usa mucha más memoria que la inferencia, y trucos como el activation checkpointing cambian cálculo extra por menos memoria.
La retropropagación también explica algunas fallas clásicas. Multiplicar muchas derivadas chiquitas a través de una pila profunda de capas puede hacer que los gradientes se achiquen hasta casi cero (desvanecimiento del gradiente) o que exploten; las conexiones residuales, las capas de normalización y una buena inicialización existen en buena parte para mantener sana esa señal. El método se descubrió más de una vez, y un artículo de 1986 de David Rumelhart, Geoffrey Hinton y Ronald Williams lo convirtió en la forma estándar de entrenar redes neuronales.
Para quedarse
- Es la regla de la cadena aplicada capa por capa, de la salida a la entrada.
- La pasada hacia adelante calcula la pérdida; la de vuelta, todos los gradientes.
- Las activaciones guardadas hacen que entrenar pida mucha más memoria que inferir.
- Los frameworks la hacen solos:
loss.backward()en PyTorch.
Para seguir leyendo
- Propagación hacia atrás en Wikipedia
- What is backpropagation really doing?, de 3Blue1Brown (en inglés)