Deduplicación
Encontrar las copias de una misma cosa y quedarse con una sola.
La deduplicación es detectar registros o pedazos de datos que en realidad son lo mismo y juntarlos en uno. Aparece en dos lugares bastante distintos: en los datos de negocio, donde el mismo cliente se cargó varias veces, y en el almacenamiento, donde el mismo archivo o bloque de bytes se guarda una y otra vez.
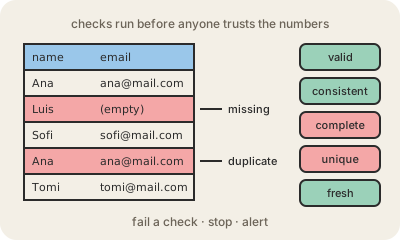
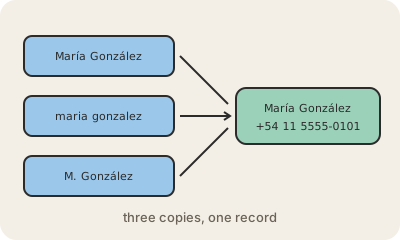
En los datos de negocio lo difícil es que los duplicados casi nunca coinciden exacto. "María González", "Maria Gonzalez" y "M. González" con el mismo teléfono probablemente son la misma persona. Las herramientas de deduplicación normalizan el texto (tildes, mayúsculas, espacios), comparan campos con coincidencia aproximada y calculan qué tan probable es que dos registros sean el mismo. Arriba de cierto umbral los fusionan; en la zona gris decide una persona. Es parte de la limpieza de datos y pesa mucho antes de contar clientes o mandar un mailing.
En almacenamiento y backups, la deduplicación trabaja con bytes crudos. El sistema corta los archivos en pedazos, calcula un hash de cada uno y guarda el pedazo solo la primera vez que ve ese hash; las copias siguientes apuntan a él. Así un servicio de backup puede guardar copias diarias de miles de notebooks sin almacenar mil veces los mismos archivos del sistema operativo. En los pipelines de datos hay una tercera variante: asegurarse de que un evento que llegó dos veces no se cuente dos veces.
Para quedarse
- Junta en una sola las copias de una misma cosa.
- En datos de negocio los duplicados son aproximados y hay que compararlos con cuidado.
- En almacenamiento, los pedazos idénticos se detectan por su hash y se guardan una vez.
- Fusionar mal puede ser peor que el duplicado, por eso importan los umbrales.