Anonimización de datos
Transformar un conjunto de datos para que nadie pueda ser identificado y siga sirviendo.
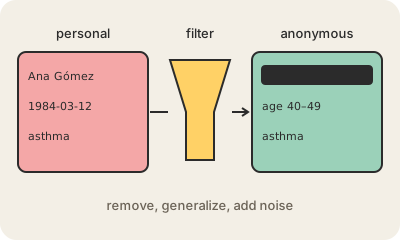
La anonimización de datos consiste en transformar datos personales para que las personas que están detrás ya no puedan ser identificadas, por nadie, con un esfuerzo razonable. Un hospital que quiere compartir historias clínicas con investigadores, o una ciudad que publica los viajes en taxi, tiene que hacer esto antes. Bien hecha, los datos siguen respondiendo preguntas útiles, como cuántas personas de cuarenta y pico tuvieron cierta enfermedad, sin señalar a nadie.
Borrar los nombres no alcanza. En un estudio muy citado del año 2000, Latanya Sweeney estimó que aproximadamente el 87% de la población de Estados Unidos podía ser identificada solo con el código postal, el género y la fecha de nacimiento. Por eso una anonimización en serio también generaliza valores (un rango de edad en lugar de la fecha exacta, una zona en vez de la calle), descarta combinaciones raras o agrega ruido, como hace la privacidad diferencial.
Es fácil confundirla con la seudonimización, que cambia los nombres por códigos pero guarda una clave en algún lado para volver a unirlos. Para el RGPD, los datos seudonimizados siguen siendo datos personales; solo los datos realmente anónimos quedan fuera de la ley. Varios casos famosos, como el conjunto de datos del Netflix Prize en 2006, mostraron que datos publicados como anónimos se podían reidentificar cruzándolos con otra información pública.
Para quedarse
- Borrar nombres no alcanza: combinaciones como código postal, género y fecha de nacimiento identifican.
- Técnicas comunes: eliminar, generalizar, suprimir casos raros, agregar ruido.
- Los datos seudonimizados se pueden volver a vincular, así que el RGPD los sigue tratando como personales.
- Siempre hay un equilibrio entre privacidad y cuán útiles quedan los datos.
Para seguir leyendo
- Seudonimización en Wikipedia
- Data anonymization en Wikipedia (en inglés)
- Considerando 26 del RGPD (en inglés)