Calidad de datos
Hasta qué punto se puede confiar en los datos para lo que se los usa.
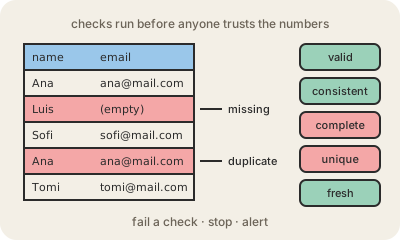
La calidad de datos es qué tan aptos son los datos para su propósito: lo bastante correctos, completos y actualizados como para que las decisiones que se toman con ellos tengan sentido. Una tabla de clientes donde falta un tercio de los mails, la misma persona aparece tres veces y la mitad de las direcciones son de 2015 tiene mala calidad, aunque la base de datos en sí funcione perfecto.
Se suele dividir en algunas dimensiones. Completitud: ¿están cargados los campos obligatorios? Validez: ¿los valores respetan las reglas, como una fecha que sea una fecha real o una edad que no sea negativa? Unicidad: ¿cada cosa está registrada una sola vez? Consistencia: ¿el mismo dato coincide entre sistemas? Oportunidad: ¿los datos de hoy llegaron hoy? Exactitud: ¿coincide con la realidad?
Los equipos cuidan la calidad con controles automáticos que corren cada vez que los datos pasan por un pipeline: si la tabla de pedidos de ayer de repente tiene cero filas o una columna llena de nulos, el control falla y alguien recibe una alerta antes de que un número equivocado llegue a un dashboard. Herramientas como los tests de dbt o Great Expectations hacen esto. Arreglar los datos después, con limpieza de datos, sirve, pero arreglar el formulario o el sistema que genera los datos malos sale más barato.
Para quedarse
- Quiere decir que los datos sirven para su uso: correctos, completos y al día.
- Dimensiones típicas: completitud, validez, unicidad, consistencia, oportunidad, exactitud.
- Los controles automáticos en los pipelines frenan los problemas antes de que lleguen a los reportes.
- Arreglar el origen le gana a limpiar los mismos errores una y otra vez.