Texto a imagen
IA que dibuja una imagen nueva a partir de una descripción escrita.
Un modelo de texto a imagen (text-to-image) crea una imagen a partir de una frase. Escribís "un carpincho leyendo el diario en un café de Buenos Aires, en acuarela" y a los pocos segundos tenés una imagen que nunca existió. DALL·E, Midjourney, Stable Diffusion, Imagen de Google y las funciones de imagen que traen chatbots como ChatGPT y Gemini hacen esto.
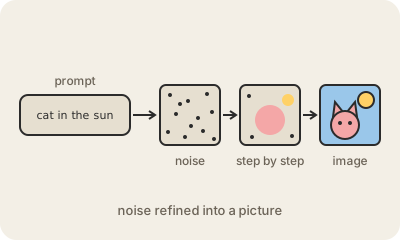
Estos modelos aprenden de colecciones enormes de imágenes con su descripción. La mayoría son un modelo de difusión: el sistema arranca de puro ruido al azar y lo va sacando paso a paso, guiado en cada paso por el sentido de tu texto, hasta que aparece una imagen coherente. Algunos sistemas más nuevos generan imágenes dentro de un modelo multimodal, con un enfoque más parecido a cómo un LLM escribe texto.
Sirven para bocetos, ilustraciones, maquetas y publicidad, y también abren preguntas de verdad. Muchos artistas reclaman que sus obras se usaron para entrenar sin permiso, y hay juicios por derechos de autor. Las fotos falsas pero realistas, los deepfakes, pueden desinformar o usarse para acosar a alguien, por eso muchas herramientas agregan una marca de agua o metadatos que indican que la imagen la hizo una IA, y leyes como la Ley de IA de la Unión Europea exigen ese tipo de etiquetado. Además, todavía se traban con algunos detalles, como escribir bien el texto de un cartel, aunque cada generación mejora.
Para quedarse
- Escribís una descripción (un prompt) y recibís una imagen nueva.
- La mayoría usa difusión: ruido que se refina paso a paso hasta ser una imagen.
- Se entrenan con enormes cantidades de imágenes con descripción, y eso alimenta el debate sobre derechos de autor.
- Muchas herramientas marcan sus imágenes como generadas por IA.