Texto a video
IA que convierte una descripción escrita en un video corto.
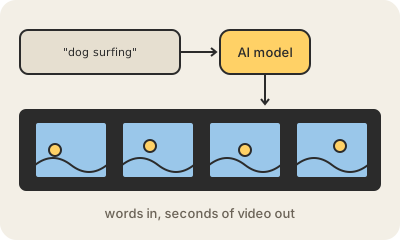
Los modelos de texto a video generan video a partir de una descripción escrita. Escribís "un golden retriever surfeando al atardecer, en cámara lenta" y, unos minutos después, tenés un clip que nadie filmó nunca. Entre los conocidos están Sora de OpenAI, Veo de Google y Runway. La mayoría también puede arrancar de una imagen y animar una foto o un dibujo.
Por dentro son parientes cercanos de los modelos de texto a imagen. Casi todos se basan en un modelo de difusión: arrancan de ruido al azar y lo van limpiando paso a paso, guiados por tus palabras. Lo difícil es el tiempo. Cada cuadro tiene que coincidir con el anterior, para que una persona mantenga la misma cara y un vaso que se rompe siga roto. Un video son muchas imágenes más movimiento, así que pide muchísimo más poder de cómputo que una sola foto; por eso los clips suelen durar segundos y muchas veces se cobran por segundo.
La calidad mejoró rápido. En 2024, la primera vista previa de Sora de OpenAI mostró clips que parecían casi filmación real, y en 2025 Veo 3 de Google sumó sonido y diálogos generados a sus videos. Quedan puntos débiles: las manos, los textos en carteles, una física que no termina de cerrar y las escenas largas que se van desarmando. Ese mismo realismo despierta temores de deepfakes, por eso las empresas agregan etiquetas visibles y marcas de agua de IA a lo que generan sus herramientas.
Para quedarse
- Convierte un prompt de texto, o una imagen, en un clip corto generado.
- Suele basarse en modelos de difusión que mantienen coherentes los cuadros.
- Cuesta mucho más que una imagen, por eso los clips suelen durar segundos.
- Fallas comunes: física rara, textos ilegibles, manos y escenas largas que se desarman.
Para seguir leyendo
- Modelo de texto a vídeo en Wikipedia
- Veo (Google DeepMind, en inglés)
- Introducing Gen-3 Alpha (Runway, en inglés)