Caída de la nube
Cuando falla un proveedor cloud y se caen con él muchas apps y sitios web.
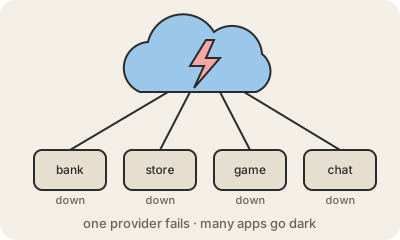
Una caída de la nube es cuando una parte de un proveedor cloud deja de funcionar: los servidores, el almacenamiento, la red o alguno de sus servicios internos clave. Como muchísimas empresas alquilan sus computadoras a los mismos pocos proveedores, una sola falla puede tirar abajo bancos, tiendas, juegos y apps de mensajería al mismo tiempo, aunque ninguno de ellos haya hecho nada mal.
Las caídas casi nunca empiezan con un data center prendiéndose fuego. Lo más común es un error chico que se propaga. En febrero de 2017, un comando mal tipeado durante un trabajo de rutina dejó sin Amazon S3 a la región de Virginia del Norte de AWS (US-EAST-1) durante horas, y muchísimos sitios se rompieron con él. En octubre de 2025, un problema de DNS con DynamoDB en esa misma región desató fallas en muchos servicios de AWS, y apps muy usadas quedaron fuera de servicio durante muchas horas.
Los proveedores tienen páginas públicas de estado y, después de los eventos grandes, publican un resumen de qué salió mal. Para las empresas, la lección es diseñar pensando en que algo va a fallar: repartir copias entre zonas de disponibilidad o incluso regiones, saber qué depende de qué y tener un plan para seguir andando a media máquina. Para el resto, es un recordatorio de que la nube son edificios reales llenos de máquinas que maneja gente.
Para quedarse
- Una falla de un proveedor puede tirar muchas apps sin relación entre sí.
- Las grandes caídas suelen empezar chicas, con un cambio o un error de configuración.
- Los proveedores publican páginas de estado y resúmenes después de eventos grandes.
- Repartirse entre zonas y regiones limita el daño.
Para seguir leyendo
- Alta disponibilidad en Wikipedia
- AWS Post-Event Summaries (en inglés)
- Google Cloud Service Health (en inglés)