Ingeniería de datos
El trabajo de armar los caños que llevan los datos a donde se pueden usar.
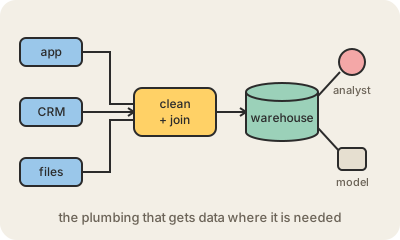
La ingeniería de datos (data engineering) es la disciplina que junta los datos de los lugares donde nacen, los limpia y los reorganiza, y los deja en un lugar confiable donde otros los puedan usar. Los datos de una empresa arrancan desparramados: la base de datos de la app, el proveedor de pagos, el CRM, planillas, registros de eventos. Un ingeniero de datos arma y mantiene los pipelines que traen todo eso a un mismo lugar, casi siempre un data warehouse o un data lake.
En el día a día, eso es escribir procesos ETL o ELT en SQL y Python, programarlos con herramientas como Airflow, modelar tablas con dbt y procesar grandes volúmenes con motores como Apache Spark. Y también la parte menos vistosa: que un proceso que falla se pueda volver a correr sin duplicar nada, darse cuenta cuando una fuente cambia de formato, cuidar los costos y lograr que los números de ayer estén listos antes de la reunión de las 9.
El rol está antes que los analistas y los científicos de datos. Ellos hacen las preguntas; la ingeniería de datos se asegura de que las respuestas salgan de datos completos, a tiempo y coherentes. Ahora que las empresas meten cada vez más datos en sistemas de IA, esta plomería se ve más, porque un modelo es tan bueno como los datos que le llegan.
Para quedarse
- Lleva datos de muchas fuentes a un warehouse o un lake, limpios y coherentes.
- Herramientas típicas: SQL, Python, orquestadores como Airflow, dbt, Spark.
- Gran parte del trabajo es confiabilidad: fallas, datos que llegan tarde, fuentes que cambian.
- Trabaja antes que analistas, científicos de datos y equipos de machine learning.