Procesamiento batch
Juntar datos durante un rato y después procesarlos todos de una sola vez.
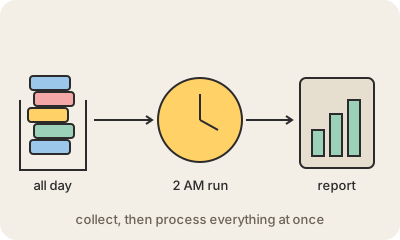
El procesamiento batch, o por lotes, consiste en manejar los datos en bloques grandes y con horario, en lugar de uno por uno a medida que llegan. Un banco junta las operaciones del día y las liquida a la noche. Una empresa calcula los sueldos una vez por mes. Un equipo de datos carga las ventas de ayer en el data warehouse todos los días a las 2 de la mañana para que los tableros estén al día a las 9.
La idea es más vieja que las pantallas: las primeras computadoras corrían pilas de tarjetas perforadas como un solo lote. Sigue vigente porque es simple y eficiente. Una corrida grande aprovecha las máquinas al máximo y después las apaga, es fácil de repetir si algo falla, y los resultados son coherentes porque todo se calculó sobre la misma foto de los datos. La mayoría de los pipelines de ETL y herramientas como Apache Spark se suelen usar así, muchas veces disparados por un cron job o un orquestador.
El costo es la demora: un informe batch está tan fresco como su última corrida. Cuando importan los minutos o los segundos, como en la detección de fraude o el seguimiento en vivo, los equipos pasan al procesamiento de streams, que atiende cada evento apenas llega. Muchas empresas usan las dos cosas: streaming para lo que tiene que ser inmediato, batch para los cálculos pesados y completos.
Para quedarse
- Procesa datos acumulados en corridas programadas, muchas veces de noche.
- Es eficiente y fácil de repetir, pero los resultados son tan frescos como la última corrida.
- El enfoque opuesto es el streaming, que procesa cada evento cuando llega.
- Usos típicos: sueldos, facturación, cargas nocturnas de ETL, informes mensuales.