Datos sintéticos
Datos inventados por un programa que se parecen a los reales, para entrenar o probar.
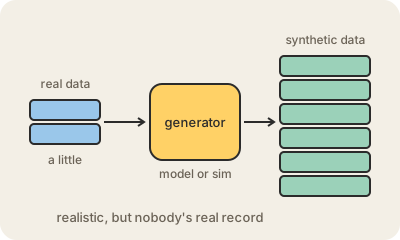
Los datos sintéticos son información generada artificialmente en lugar de recolectada del mundo. Un programa, una simulación o un modelo de IA produce registros, imágenes o textos que tienen la misma forma y los mismos patrones que los datos reales, pero que no describen a ninguna persona ni a ningún hecho de verdad.
Resuelven tres problemas habituales. Privacidad: un hospital puede compartir historias clínicas sintéticas que mantienen las estadísticas de las reales sin exponer a nadie. Escasez: un auto autónomo casi nunca ve a un nene cruzando detrás de una pelota al atardecer, pero un simulador puede generar miles de escenas así. Costo: escribir a mano diez mil pares de pregunta y respuesta lleva semanas, mientras que un modelo grande puede armar un borrador en una tarde, y eso ya es parte normal de cómo se entrenan y ajustan los LLMs.
La trampa es que los datos sintéticos son tan buenos como lo que los generó. Copian los sesgos y los puntos ciegos de su fuente, y pueden perderse los casos raros que hacen difíciles a los datos reales. Además, se vio que los modelos entrenados una y otra vez con lo que producen otros modelos van perdiendo variedad y calidad, un efecto que se llama colapso del modelo (model collapse). En la práctica, lo que mejor funciona es mezclar datos sintéticos con reales y revisar bien los dos.
Para quedarse
- Datos artificiales que imitan los patrones de los datos reales.
- Ayudan con la privacidad, los casos raros y el costo de juntar ejemplos.
- Heredan los sesgos y huecos de lo que sea que los generó.
- Funcionan mejor mezclados con datos reales, no en su lugar.