Ingeniería de confiabilidad
Operar sistemas en producción con ingeniería de software y un presupuesto para fallar.
La ingeniería de confiabilidad de sitios, conocida por su sigla en inglés SRE (site reliability engineering), es una forma de mantener confiables los servicios online tratando la operación como un problema de software. Nació en Google en 2003, cuando a Ben Treynor Sloss le encargaron un equipo de producción formado por ingenieros de software. En vez de arreglar servidores a mano, los SRE escriben código que despliega, escala, monitorea y repara sistemas, y buscan automatizar el trabajo manual repetitivo, al que llaman toil.
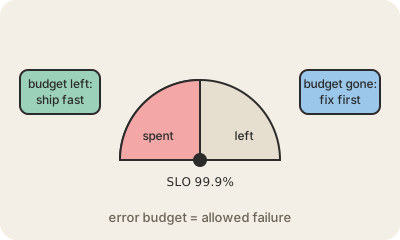
Su idea más conocida es el presupuesto de errores (error budget). El equipo acuerda un SLO, un objetivo de confiabilidad como "el 99,9 % de los pedidos sale bien cada mes". El 0,1 % restante es el presupuesto: el margen para fallar. Mientras quede presupuesto, los desarrolladores sacan funciones nuevas rápido. Si los incidentes se lo comen, se frenan los lanzamientos y el esfuerzo pasa a la confiabilidad. Así, la pelea de siempre entre "ir rápido" y "no romper nada" se convierte en un número que las dos partes aceptan.
Los SRE también se reparten las guardias, coordinan la respuesta cuando algo se rompe y después escriben postmortems sin culpables. Hoy muchas empresas tienen equipos de SRE, y el término también se usa como puesto de trabajo. Se superpone bastante con DevOps; una forma común de decirlo es que SRE es una manera concreta y medible de hacer DevOps.
Para quedarse
- Operación a cargo de ingenieros que escriben software para manejar sistemas.
- Nació en Google en 2003.
- Presupuesto de errores: la falla que permite el SLO, gastada en ir rápido.
- Reduce el toil, reparte guardias y escribe postmortems sin culpables.
Para seguir leyendo
- Introducción al libro Site Reliability Engineering de Google (en inglés)
- Embracing risk, sobre presupuestos de errores (en inglés)
- Site reliability engineering en Wikipedia (en inglés)