OCR
Software que lee el texto de una imagen para poder buscarlo y editarlo.
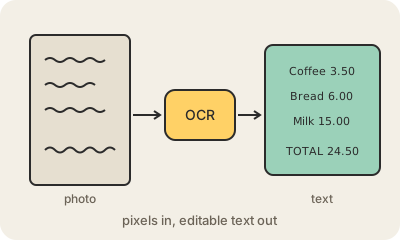
Para una computadora, la foto de un ticket son solo puntitos de colores. El OCR (reconocimiento óptico de caracteres) convierte esos puntitos en texto de verdad: letras y números que podés buscar, copiar, pegar en una planilla o hacer leer en voz alta. Es lo que te deja copiar el texto de una foto en el celular, buscar dentro de un PDF escaneado o depositar un cheque sacándole una foto.
El OCR clásico trabajaba por pasos: limpiar la imagen, encontrar los renglones, separarlos en caracteres y comparar cada uno con formas conocidas. Los sistemas actuales usan redes neuronales que leen palabras o renglones enteros de una vez, y se las arreglan mucho mejor con tipografías raras, fotos torcidas y letra manuscrita. Hay motores de código abierto como Tesseract que corren en cualquier computadora, y los modelos de IA multimodal ya pueden leer un documento y además entenderlo: sacar el total de una factura o pasar a planilla una tabla de una foto.
Igual no es perfecto. Las fotos movidas, las fotocopias gastadas, los formatos raros y la letra desprolija generan errores, como un 0 leído como O o un 1 como l, así que todo lo importante (montos, números de documento, datos médicos) merece que lo revise una persona. El OCR también es clave para la accesibilidad: un lector de pantalla solo puede leer en voz alta un documento escaneado después de que el OCR lo convirtió en texto.
Para quedarse
- Convierte imágenes de texto en texto real, que se puede buscar y editar.
- El OCR actual usa redes neuronales y lee mejor la letra manuscrita.
- Los modelos multimodales pueden leer un documento y sacar los datos que necesitás.
- Revisá los números importantes: los caracteres parecidos se siguen confundiendo.
Para seguir leyendo
- Reconocimiento óptico de caracteres en Wikipedia
- Tesseract, un motor de OCR de código abierto (GitHub, en inglés)