Particionado de datos
Partir una tabla enorme en pedazos según una clave, para leer solo lo necesario.
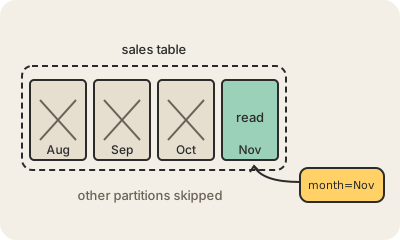
El particionado de datos consiste en dividir una tabla o un conjunto de datos grande en pedazos más chicos, llamados particiones, según una columna como la fecha, el país o el ID de cliente. Para quien escribe SQL sigue pareciendo una sola tabla, pero por debajo cada partición se guarda por separado.
La ganancia principal es la poda de particiones (partition pruning). Si una tabla de ventas está particionada por mes y pedís noviembre, la base lee solo la partición de noviembre y saltea por completo los otros años de datos. En un data lake la misma idea aparece como carpetas del estilo year=2026/month=11/ llenas de archivos Parquet, y motores como Spark o Athena leen solo las carpetas que coinciden. Las particiones también abaratan el mantenimiento: borrar un mes viejo es tirar una partición, no salir a buscar millones de filas.
Cuando las particiones se reparten entre distintos servidores se llama sharding, y es la forma en que las apps muy grandes distribuyen la carga más allá de lo que aguanta una sola máquina. Lo difícil es elegir la clave. Si particionás por algo que las consultas casi nunca filtran, no ganás nada; si elegís una clave donde un solo valor se lleva casi todo el tráfico, como un cliente gigante, armás una partición caliente que se vuelve el cuello de botella mientras las demás están ociosas.
Para quedarse
- Divide una tabla por una clave como fecha o región; las consultas la siguen viendo como una sola.
- La poda de particiones permite saltear todo lo que la consulta no necesita.
- El sharding es particionar repartiendo entre varios servidores.
- Una clave mal elegida no acelera nada o genera una partición caliente.
Para seguir leyendo
- Partición (base de datos) en Wikipedia
- Particionado de tablas (documentación de PostgreSQL, en inglés)